 A.I. 日报
第 2026-11-18 期 · 行业追踪 · 开源 · 研究 · 模型发布
用Transformers将180B MoE模型推理压入32GB内存
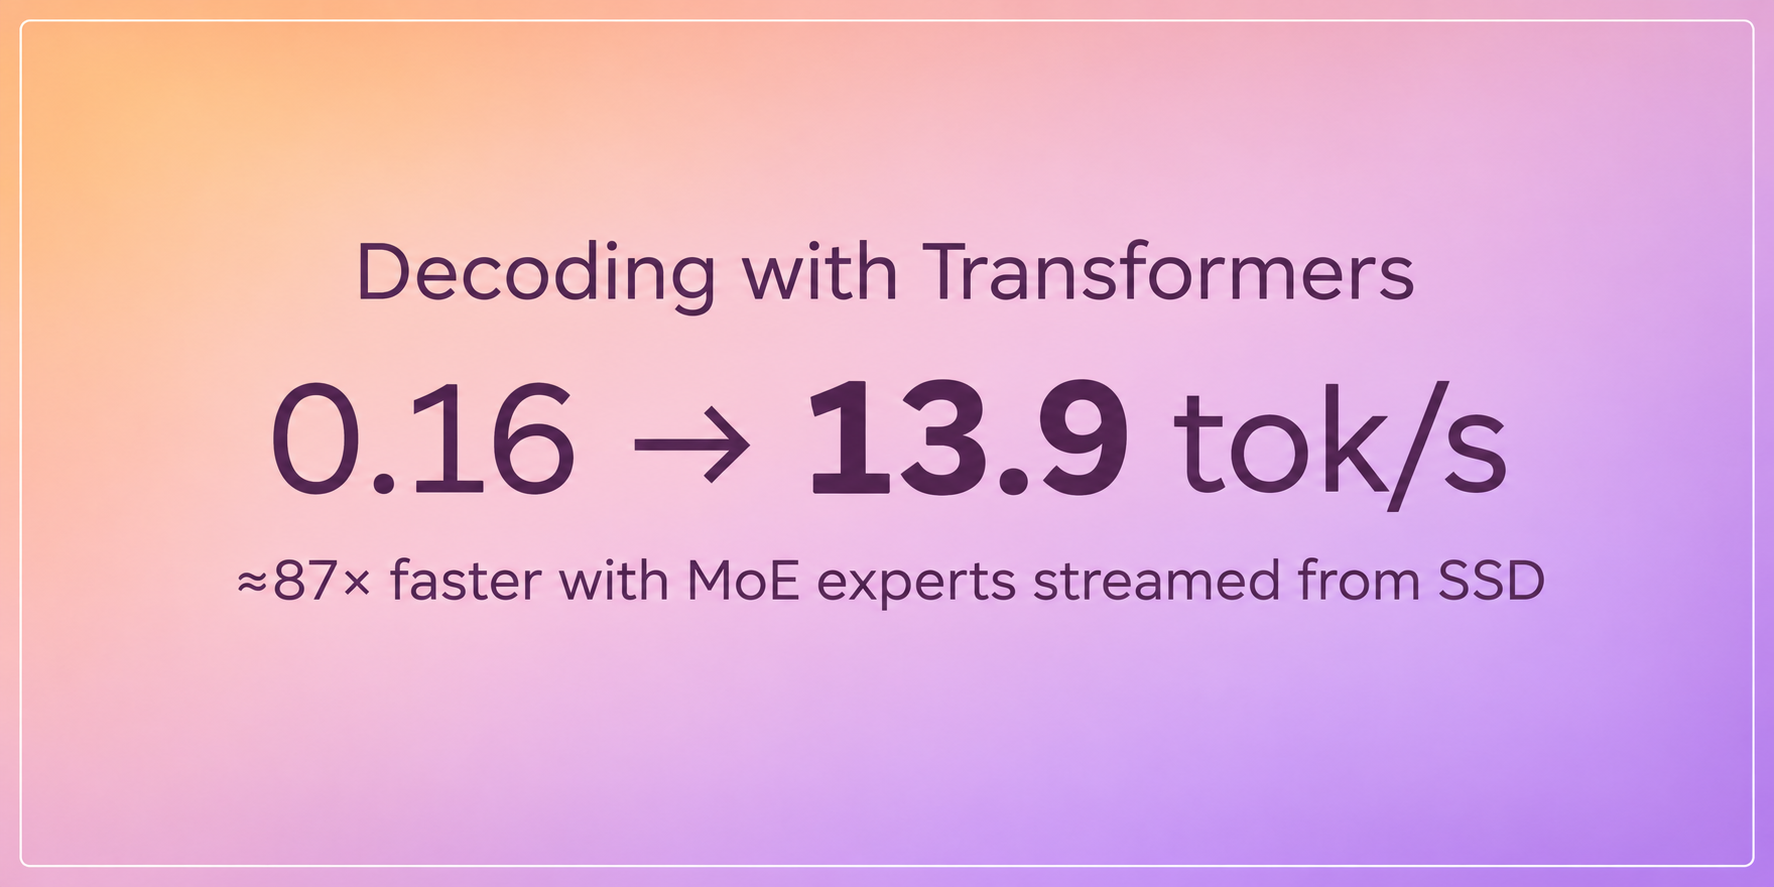
一篇Hugging Face博客介绍了在Transformers中通过从SSD流式加载MoE专家权重,让180B参数模型在32GB内存上运行,token生成速度仅比Strata低6%。由于专家占MoE权重的90%以上,只保留热专家在显存、其余放入内存或磁盘,可在消费级硬件上运行大模型。
查看原文 ↗一篇Hugging Face博客介绍了在Transformers中通过从SSD流式加载MoE专家权重,让180B参数模型在32GB内存上运行,token生成速度仅比Strata低6%。由于专家占MoE权重的90%以上,只保留热专家在显存、其余放入内存或磁盘,可在消费级硬件上运行大模型。
查看原文 ↗